Primer modelo entrenado desde cero: 112 millones de parámetros, 3 horas, y ya escribe en español (sin sentido todavía)
Hoy a las 08:14 terminó el ensayo que llevaba toda la noche corriendo en el portátil: un modelo de lenguaje entrenado desde cero, sin partir de ningún modelo ajeno, con nuestro propio tokenizador de 48.000 piezas y nuestros propios datos (web filtrada en español y un año del BOE). No es un modelo útil: es la prueba de que todas las piezas encajan antes de pedir cómputo de verdad.
Qué se entrenó
| Arquitectura | Decodificador tipo Llama: 12 capas, dimensión 768, 12 cabezas (4 de clave/valor), SwiGLU, RoPE |
| Parámetros | 112 millones (36,9 M en los embeddings, compartidos con la capa de salida) |
| Tokenizador | Propio, v2, 48.000 piezas |
| Datos | 209.180 documentos, unos 190 millones de tokens: FineWeb-2 español + BOE de noviembre de 2025 a octubre de 2026 |
| Contexto | 1.024 tokens |
| Pasos | 3.000, con 32.000 tokens por paso: unos 98 millones de tokens vistos (media época) |
| Hardware | Una RTX 5050 de 8 GB; 3,42 segundos por paso; 2 h 56 min en total |
La curva
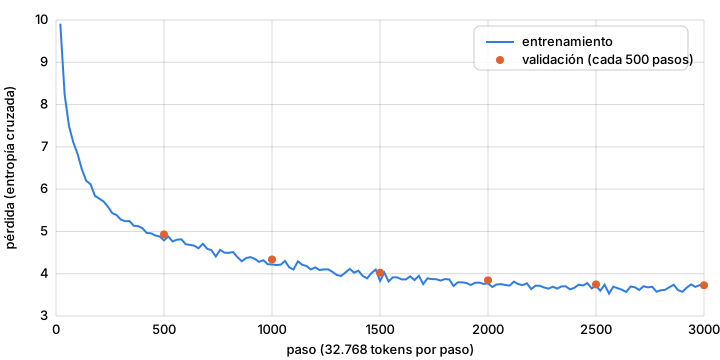
| Paso | Pérdida de entrenamiento | Pérdida de validación | Perplejidad |
|---|---|---|---|
| 20 | 9,91 | 20.000 | |
| 500 | 4,96 | 4,93 | 138 |
| 1.000 | 4,22 | 4,34 | 76 |
| 1.500 | 4,10 | 4,02 | 56 |
| 2.000 | 3,79 | 3,84 | 47 |
| 2.500 | 3,72 | 3,75 | 42 |
| 3.000 | 3,67 | 3,73 | 41 |
La curva baja de forma limpia y sin saltos, y la pérdida de validación sigue a la de entrenamiento: no hay sobreajuste ni problemas de datos. La curva completa está en el repositorio (modelo/entrenamiento/curvas/pre-100m-v2.json).
Qué escribe
Le dimos cinco principios de frase y dejamos que continuara. Un ejemplo, tal cual:
La ciudad de Murcia es / Las mejores ofertas - 1.1 ¿Qué mejor opción comprar? - 2.2 ¿Cuál es la mejor oferta para ti? - 3.4 ¿Cómo se puede adquirir una tienda en línea?
Y otro:
El BOE publica hoy una resolución de la Dirección General de / En el marco del proyecto "Misión por los municipios" que se celebrará en La Laguna, desde hace unos días, en un acto público, y a través de la Comisión Nacional de los Mercados y la Competencia (CNTE), donde se recogen las actuaciones relacionadas con el desarrollo de proyectos urbanos.
El español es correcto: concordancias, puntuación, nombres de organismos, estructura de noticia o de listado. El contenido no tiene ningún sentido y el modelo ignora el principio que le damos: con 100 millones de tokens vistos aprende la forma de la lengua, no todavía el significado. Es exactamente lo esperado para este tamaño y esta cantidad de datos; un modelo de 1.000 millones de parámetros necesita mil veces más tokens.
Qué hemos validado
- Los datos se cargan, se tokenizan y se mezclan (web + BOE) sin errores.
- El tokenizador propio funciona de punta a punta en el entrenamiento.
- El código de preentrenamiento, los checkpoints cada 500 pasos y la evaluación periódica funcionan en una GPU de 8 GB.
- Sabemos el coste real: 3,4 segundos por paso de 32k tokens en una GPU pequeña. Con eso podemos estimar con precisión lo que pediremos a la Red Española de Supercomputación.
Qué fallo hubo
El primer lanzamiento se quedó sin memoria: con un vocabulario de 48.000 piezas, la tabla de probabilidades de un lote de 8 secuencias no cabe en 8 GB. Se bajó el lote a 2 secuencias con acumulación de 16 pasos (mismo lote efectivo). Y el cambio no se aplicó a la primera por un error de edición, así que el ensayo arrancó dos veces. Todo queda en el historial del repositorio.
Siguiente
Con la GPU libre, arranca la generación de instrucciones legales a partir del BOE con cita de fuente, para el afinado de dominio que sí tiene sentido hacer.
modelopreentrenamientotokenizadordatos