Segundo ensayo desde cero: con el BOE completo y el doble de pasos, la perplejidad baja de 41 a 25
Mientras la nube indexaba el BOE y medíamos la búsqueda, el portátil ha pasado la tarde entrenando el segundo ensayo desde cero: el mismo modelo de 112 millones de parámetros y el mismo tokenizador que esta mañana, pero con el corpus ampliado con las 1.182 disposiciones generales de la sección I (207 millones de tokens en total) y el doble de pasos. 6.000 pasos de 32.768 tokens, casi una época entera, 5 h 46 min, 3,44 segundos por paso.
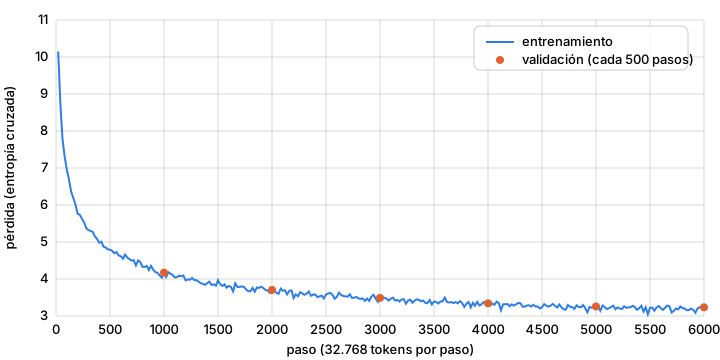
Comparación con el ensayo de esta mañana
| Paso | v2 (190 M tokens, 3.000 pasos) | v3 (207 M tokens, 6.000 pasos) |
|---|---|---|
| 1.000 | 4,34 | 4,17 |
| 2.000 | 3,84 | 3,71 |
| 3.000 | 3,73 (final) | 3,49 |
| 4.000 | 3,34 | |
| 5.000 | 3,26 | |
| 6.000 | 3,24 |
Pérdida de validación (entropía cruzada por token). En perplejidad: de 41 a 25. La mejora viene de dos cosas que no podemos separar con un solo experimento: más datos (y de más calidad) y más pasos. La curva aún baja al final: el modelo no ha saturado. Un modelo de este tamaño admitiría diez veces más tokens antes de estancarse.
Qué escribe ahora
El BOE publica hoy una resolución de la Dirección General de / Por Juan Carlos Moreno. Publicado 24/03/2015 11:24 PM. La Universidad Nacional Autónoma del Estado de Chihuahua (UNAM), en colaboración con la UPNC, ha presentado hoy una solicitud de renovación de la sede central de la Facultad de Ciencias Económicas y Empresariales…
Español correcto, estructura de noticia o de web, nombres y fechas verosímiles, y todavía ninguna fidelidad al principio de frase que le damos. Es lo normal a esta escala; lo que ha cambiado respecto a esta mañana es que las frases son más largas y coherentes entre sí.
Un detalle técnico que vamos a mirar
En todas las muestras el modelo ignora el texto de arranque y empieza como si fuera un documento nuevo ("…publica hoy una resolución de la Dirección General de" seguido de "Por Juan Carlos Moreno"). Sospechamos del empaquetado de los documentos en secuencias de 1.024 tokens sin un separador claro: el modelo aprende que tras cualquier corte viene un documento nuevo. Es una comprobación para el próximo ensayo, no para hoy.
Para qué sirve esto
Tenemos dos curvas públicas, reproducibles, con configuración y datos documentados, y el coste medido de cada paso. Es lo que acompañará a la solicitud de horas de supercomputación: no una promesa, sino un experimento que ya funciona a pequeña escala y que solo necesita multiplicarse por mil.
modelopreentrenamientodatosmedidas