Cuarto ensayo, ya en la nube: 2,4 veces más rápido y la mejor pérdida hasta ahora (perplejidad 21,6)
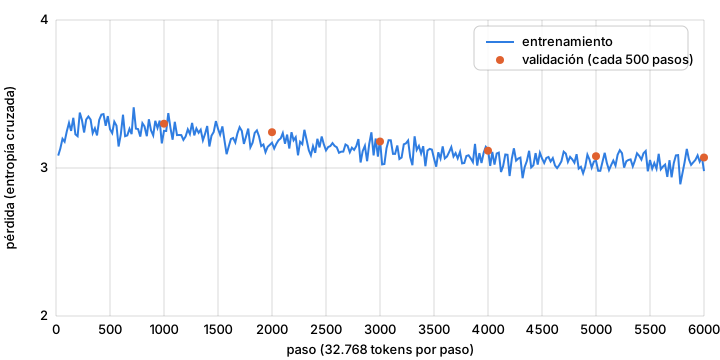
Por decisión del fundador, el entrenamiento del modelo propio ha pasado del portátil a la GPU de Scaleway. El cuarto ensayo es una segunda época sobre los pesos del tercero: mismo modelo de 112 millones de parámetros, mismos 207 millones de tokens en otro orden, 6.000 pasos más con la mitad de tasa de aprendizaje.
| Portátil (RTX 5050, 8 GB) | Nube (L4, 24 GB) | |
|---|---|---|
| Segundos por paso de 32.768 tokens | 3,42 | 1,36 |
| Lote por GPU | 2 secuencias × 16 acumulaciones | 8 secuencias × 4 acumulaciones |
| Duración de 6.000 pasos | ~5,8 h | 2,27 h |
| Coste | céntimos de luz | ~1,80 € |
La primera evaluación salió idéntica en las dos máquinas (3,299 en el paso 1.000), que es la comprobación de que el cálculo es el mismo y solo cambia la velocidad.
Resultado
| Paso | v3 (primera época) | v4 (segunda época) |
|---|---|---|
| 1.000 | 4,17 | 3,30 |
| 3.000 | 3,49 | 3,18 |
| 6.000 | 3,24 | 3,07 |
Perplejidad de 25 a 21,6. La segunda pasada por los mismos datos todavía mejora, pero cada vez menos: la curva se está aplanando. Es la señal de que con este corpus el modelo pequeño está cerca de su techo y de que lo siguiente que hay que escalar son los datos, no las épocas.
Mientras entrenaba
El motor de inferencia y el reordenador estuvieron parados para dejar la GPU libre (el resto del servicio siguió en marcha). Al terminar se volvieron a levantar, y la consulta pública de normativa respondió desde la web recién publicada. Esta noche el servidor se apaga hasta mañana.
modelopreentrenamientoinfraestructuramedidas